随手拍一段视频,AI 就能还原出一个可以 360°旋转视角的数字人?这不是科幻片,已经有研究团队做出来了。
(信源:科技日报,2026年8月)
我们平时拍视频,最大的遗憾不是画质不够,而是视角太单一,孩子第一次走路只能看到正面,朋友登台表演只能记录一个方向,连自家宠物突然做出搞笑动作,也很难把它完整留下来,镜头没拍到的地方,就像从记忆里被剪掉了一块。
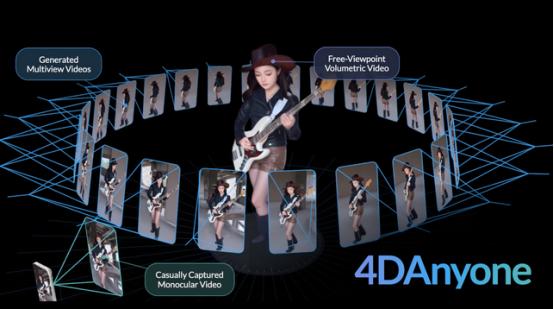
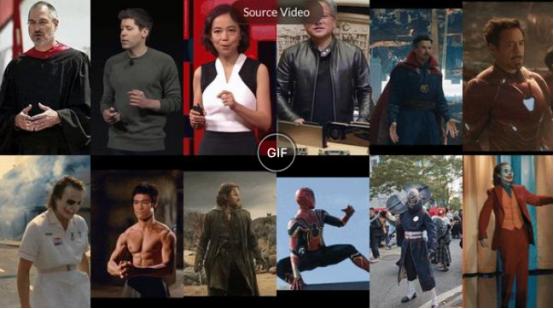
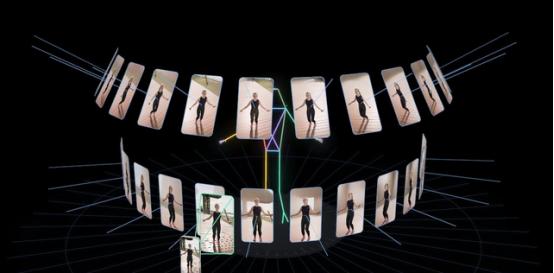
4DAnyone的思路,说白了就是让AI替你补上那些没拍到的角度,它先从普通单目视频里估计人物的三维骨架,再生成多组视角一致的视频,最后把这些内容转换成4D高斯泼溅模型,人物不只会动,还能随着观察者的视线转身。
这里的关键不是把某一张图做得多漂亮,而是让几十个角度看起来像同一个人。
过去的多视角生成经常出现正面穿红衣,转到侧面突然变蓝,左手和右手对不上,脸型也会悄悄变化,单张看着还行,连起来就像换了演员。
研究团队专门设计了RCP和TCR两个机制,前者把已经生成的视角压缩成一份稳定记忆,后者让不同视角在生成早期反复交换信息,先把身材轮廓和动作关系统一,再去补衣服纹理和面部细节,这个顺序很像盖房子,地基没歪,装修才有意义。
我觉得这项工作的价值,不在于又多了一个炫技演示,而在于它把数字人的入口往普通人身边挪了一大步。
过去做动态人体重建,往往要专业摄影棚和多机位阵列,设备昂贵,流程复杂,普通创作者连试错的机会都没有。
以后拍家庭影像,可能不只是保存一段二维视频,而是保存一个可以重新观看的空间记忆,孩子长大后还能从不同角度看自己第一次走路的样子,这种体验和翻相册完全不是一回事。
当然也可能有人觉得背后发凉,毕竟记忆一旦变成立体数据,就更值得长期保存和保护。
电商行业也会被它吸引,一件衣服只拍一段上身视频,消费者就能从侧面和背面查看版型,模特不必反复补拍,商家少搭一次棚,设计师也能更快确认效果,内容生产的成本会往下走,普通小商家反而可能先吃到这波红利。
游戏和影视制作同样如此,过去为了得到一个能自由转动的数字角色,需要大量机位、灯光标定和后期处理,现在单目视频提供了更轻量的起点,虽然离工业级成片还有距离,但从不能做,到能做出可用雏形,这一步已经很关键。
更值得注意的是,它没有把深度图当成唯一依赖,而是选择用3D骨架提供结构约束。
因为手持手机拍摄时,光线、遮挡和镜头移动都会影响深度估计,骨架虽然不够细,却更稳,先保证人站得住、动得对,再让模型处理衣服和皮肤,路线相当务实。
手机拍完就得到完美数字人,目前还没那么轻松,宽松飘动的裙摆、快速转身、复杂遮挡和少见动作,都会让模型犯难。
尤其是背面本来就没有真实画面,AI生成的部分,本质上是基于训练经验做出的合理推测,不能当成百分之百的原始记录。
我更关心的是边界怎么画,未经同意拿别人的视频制作可操控数字人,可能侵犯肖像和隐私,把普通人的生活影像随便上传,也有数据泄露风险,技术越方便,授权、标注和追责就越不能含糊,开源值得鼓励,但使用规则也要跟上。
4DAnyone给出的信号很明确,AI正在从生成一张图、写一段话,走向重建一个可以被观察、被编辑、被交互的动态世界,这会改变短视频、电商、文旅、教育和影视的制作方式。
我的判断是,真正的变化不会发生在发布当天,而会发生在越来越多人把它装进日常工作之后。
一段普通视频,过去只能回放,现在有机会变成一个可旋转、可研究、可再次创作的数字对象,这不是把现实变魔术,而是让现实多了一种保存方式,至于这扇门最后通向创作自由,还是通向新的隐私考验,答案取决于我们怎么使用它。