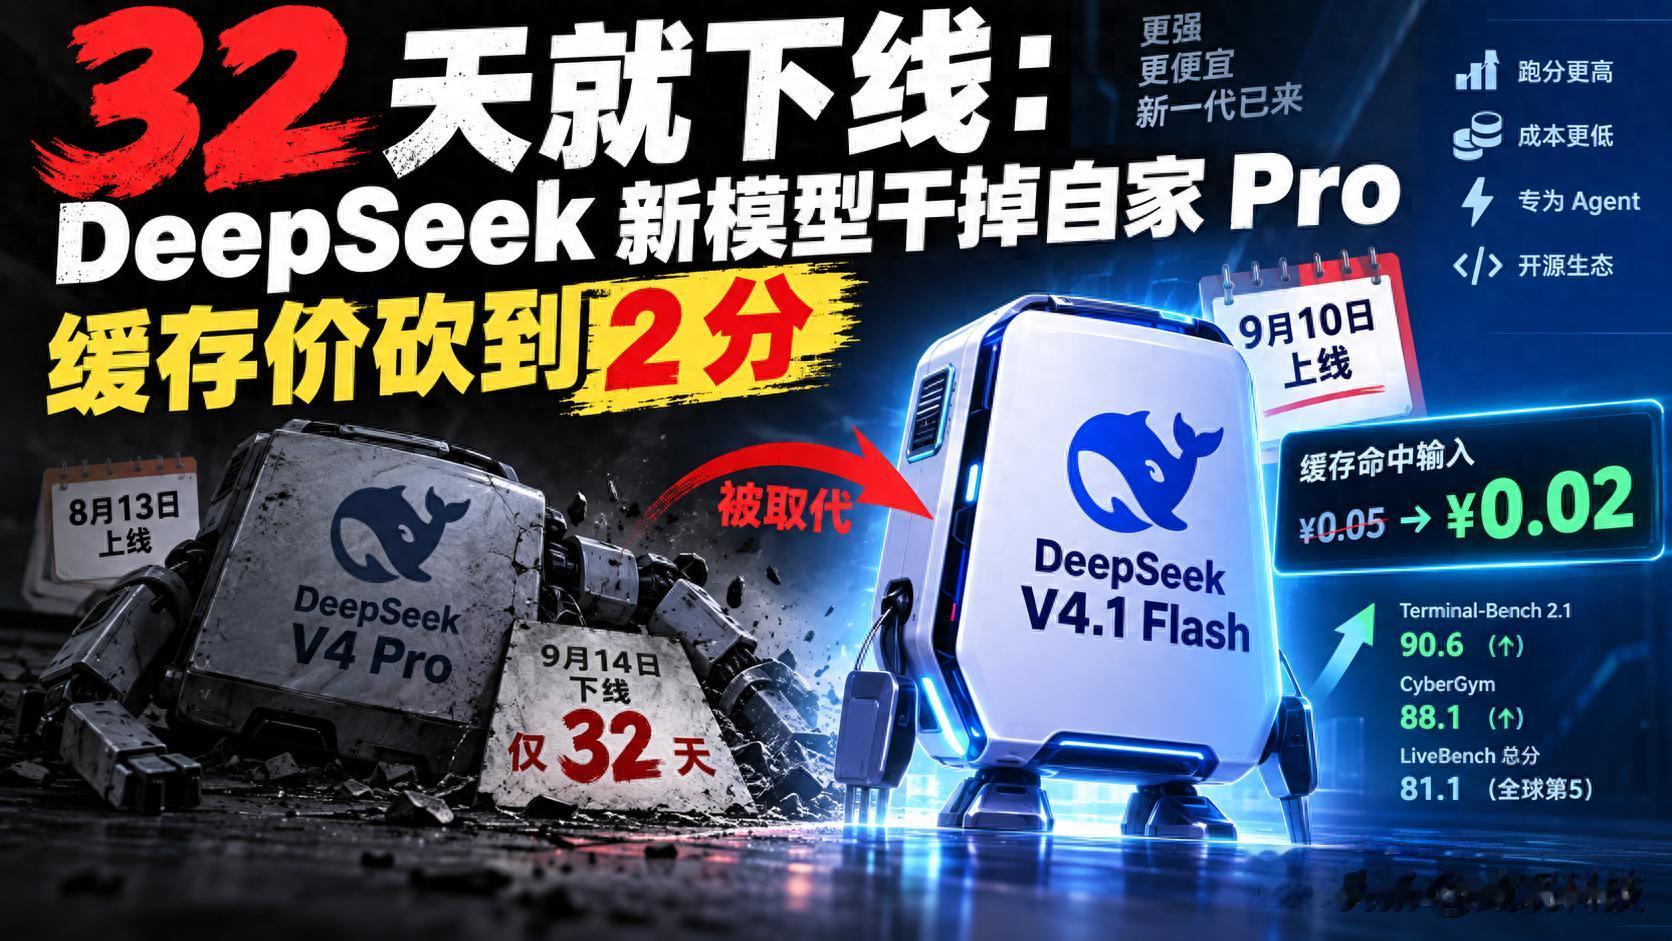
我看到那份公告的时候,先确认了一遍日期有没有看错。没有,就是 32 天。
一、下线通知写得很平静9 月 10 日,DeepSeek 发布 V4.1 Flash,同一天在开放平台挂出通知:北京时间 9 月 14 日 12 点起,所有对 deepseek-v4-pro 的请求自动路由到新模型,按 Flash 的单价计费。
V4 Pro 是 8 月 13 日上线的,构建号 0813,1.6T 总参数、49B 激活,主打百万上下文。
接棒的 V4.1 Flash 参数反而小了一圈,总参 552B,混合专家模型。跑分却是反过来的。官方给出的对比里,Terminal-Bench 2.1 拿到 90.6,V4 Pro 之前是 87.9;网络安全测试 CyberGym 拿到 88.1,V4 Pro 是 83.3。
第三方榜单也对得上。LiveBench 上 V4.1 Flash 总分 81.1,排全球第五,比 GPT-5.6 Sol 高 0.1 分,比自家 V4 Pro 高 3.7 分。Agentic Coding 一项 77.3,是那份榜单里的最高分。Arena 刚更新的 WebDev 前端编程榜,它空降第 14 名,比 V4 Pro 高 40 分。
一个挂着"Flash"名字的模型,把自家旗舰挤下了场。
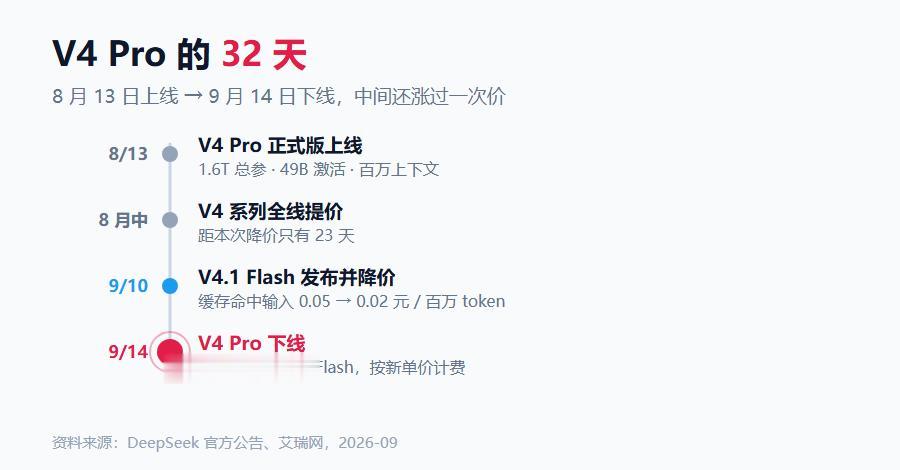 V4 Pro 从上线到下线只有 32 天,中间还涨过一次价(数据来自 DeepSeek 官方公告、艾瑞网)
二、读得便宜,写得贵一点参数变小反而更强,原因在架构上。
V4.1 Flash 用的是全新的 Causal Encoder-Decoder 结构,业内简称 CED。做法是把 40 层 Transformer 从中间劈开,前 20 层当编码器读入上下文,后 20 层当解码器生成输出。关键是两半的算力配比不一样,读的时候只激活 8B 参数,写的时候激活 16B。
为什么要这么设计?因为 KV Cache 太贵了。
模型每处理一个 token,都要在显存里存一份缓存,上下文越长这笔开销越大。跑 Agent 任务的时候,这部分成本甚至可能超过推理计算本身。DeepSeek 的解法是让解码器不再自己逐层算缓存,直接从编码器最后一层的输出投影过来,再叠加 FP4 量化和跨层共享索引。
效果是每个 token 的全局 KV Cache 从上一代的 3514 字节压到 890 字节。落到硬件上,对高带宽内存的需求降到原来的四分之一,对固态硬盘的需求降到八分之一。
这个方向跟 Agent 的干活方式对得上。读代码仓库、翻长文档、回看历史对话,输入的量远大于输出的量。把读取那一段的计算压下来,账就省出来了。
三、涨完 23 天又降回来降价跟发布是同一天。新价格从 9 月 10 日 12 点生效,还是峰谷定价,高峰时段是空闲时段的两倍。
三项里降得最狠的是缓存命中输入,从 0.05 元砍到 0.02 元,降幅 60%;缓存未命中输入从 1.5 元降到 1 元;输出从 4.5 元降到 4 元,只降了 11%。
缓存命中输入是 API 账单里的大头。按固定用量测算,100 万缓存命中输入、10 万未命中输入、1 万输出,空闲时段一次任务从 0.245 元降到 0.16 元。
但这里有个容易被忽略的时间线。据艾瑞网援引官方公告,DeepSeek 在 8 月中旬刚对 V4 系列全线提过一次价,这次调整距涨价只有 23 天;而且输出价虽然回调,仍是首发价的两倍。
另一层压力来自开源。V4-Flash 用的是开源权重,聚合平台 OpenRouter 上已经有 28 家第三方供应商提供该模型的 API 服务,不少报价低于官方。官方把这次调整表述为"合理调配资源"。
涨完又降,降了也没回到原点。这笔账其实挺拧巴的。
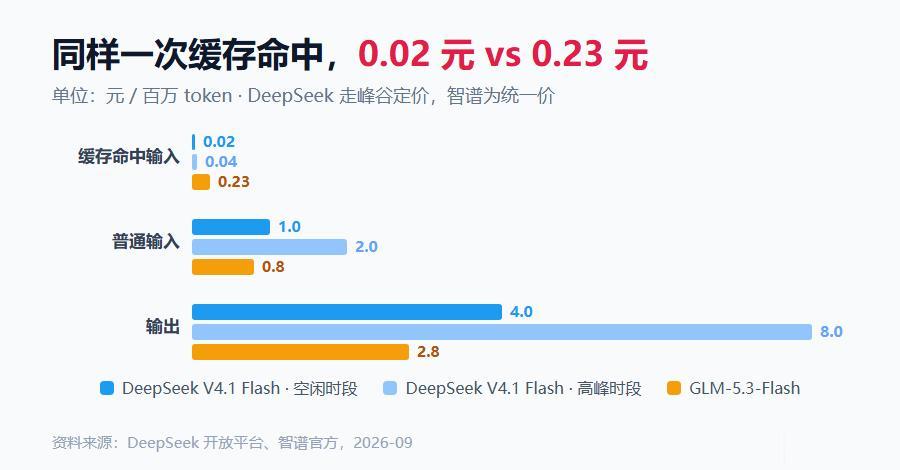 缓存命中输入是 API 账单里的大头,这一项两家差了十倍多(数据来自 DeepSeek 开放平台、智谱官方)
四、智谱那头牛和 DeepSeek 这条鲸鱼在 DeepSeek 之前,另一个 Flash 已经火过一轮。
8 月 20 日,智谱在 OpenRouter 和 OpenCode 上线了一个匿名模型,代号 Ox-Alpha,中文名"牛来"。它首日就冲上 OpenRouter 榜首,刷新了平台单日 token 调用量纪录,也终结了 DeepSeek 在 OpenCode 连续 56 天的霸榜。8 月 26 日,智谱官宣认领,真身是 GLM-5.3-Flash。
两个模型像得离谱。都是 MoE,都是 100 万 tokens 上下文,都原生支持多模态,都是 MIT 协议开源,连推理力度都能调。但解决 KV Cache 太贵这道同一道题,走的是两条路。
DeepSeek 走非对称路线,输入端激活 8B、输出端激活 16B,读比写便宜,专为 Agent 场景设计。智谱走对称路线,输入输出都激活 18B,总参数从 GLM-5.3 的 753B 砍到 320B,用 34 层线性注意力加 11 层稀疏注意力的混合结构替代全注意力,再把索引器的 4 个缓存向量池化成 1 个。
价格上互有胜负。缓存命中输入,DeepSeek 空闲时段 0.02 元,智谱 0.23 元,差了十倍多;但普通输入智谱 0.8 元比 DeepSeek 空闲时段的 1 元便宜,输出 2.8 元也比 4 元便宜。高峰时段 DeepSeek 翻倍之后,差距拉到 2.8 元对 8 元。智谱还有 Coding Plan 订阅,月付 118 元起;DeepSeek 目前只有按量付费。
跑分上,LiveBench 总分 DeepSeek 81.1、智谱 71.6,差近 10 分。不过智谱的多模态更完整,文件和视频输入都支持,DeepSeek 这边是文本加图片。
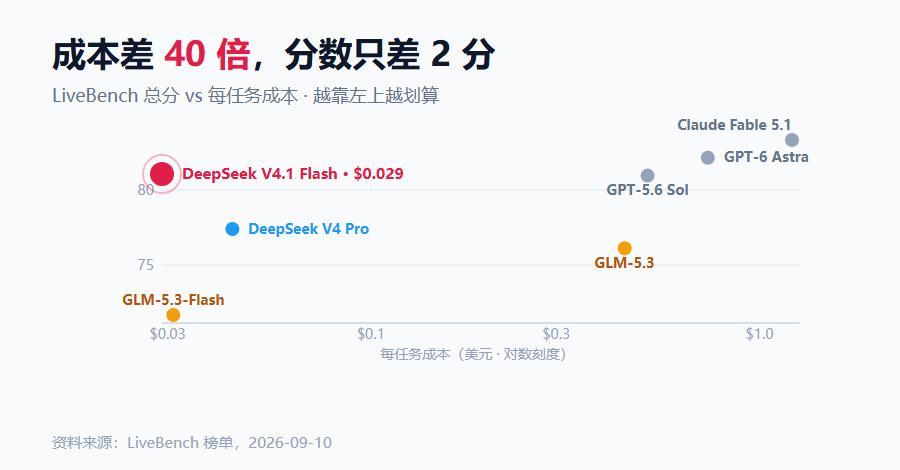 LiveBench 上 DeepSeek V4.1 Flash 每个任务花 0.029 美元,总分只比最贵的 Claude Fable 5.1 低 2.3 分
五、腾讯的站位这次更新里有个细节值得单独拎出来:腾讯旗下的 WorkBuddy、CodeBuddy 和 OpenCode 一起成了 V4.1 Flash 的官方合作伙伴,已全量接入。
据第一财经报道,腾讯在 DeepSeek 首轮融资中出资约 100 亿元,是最大的外部投资方。Tencent AI 在社交平台上的表态挺有意思:"我们也有自己的模型,但开源胜过私有,这一点一直都是。"
一家自己有模型的公司,去给别人的开源模型做独家联合推广,还带两周优惠。这笔账怎么算,各有各的说法。
再往远一点看,据市场消息,DeepSeek 第二轮融资计划募资 500 亿元,投前估值约 5000 亿元;9 月 9 日又有报道称公司已与中信证券接触,考虑筹备科创板上市,最早可能在 2026 年底提交申请。截至目前,DeepSeek 对上述融资和上市消息没有公开回应。
六、写在最后一款旗舰模型的保质期只有 32 天,这事放在两年前没人信。
但真正麻烦的不是模型换代快,是换代快带来的迁移成本。开发者要算的账不只是 token 单价,还有适配、重测,以及半夜起来改配置的工钱。
我现在比较好奇的是 V4.1 Pro。Flash 已经把 Pro 挤下去了,下一个 Pro 得拿出什么东西来,才能坐稳这个位置。
文中的价格和跑分来自 DeepSeek 官方公告与公开榜单,融资和上市的部分是媒体报道口径,公司没有回应过。