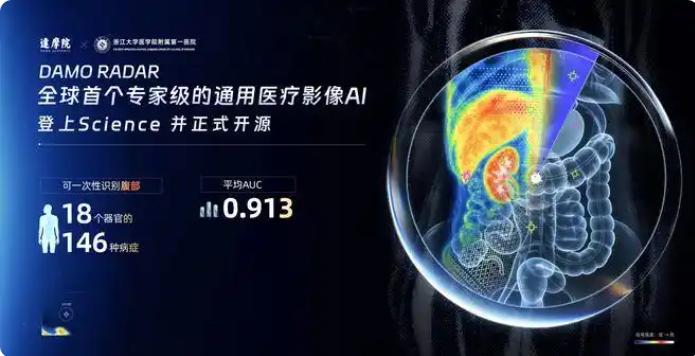
这下美国媒体高兴不起来了,半年时间不到,中国团队就把他们刚庆祝完的里程碑,直接翻篇了!9月18日,阿里达摩院和浙大一院联合研发的DAMO RADAR登上了《科学》,这个模型覆盖腹部18个器官,能识别146种病症,在近4万次真实临床检查中AUC达到0.913,与26名放射科医生的人机对比试验里,平均准确率超过了其中23名。
距离斯坦福的Merlin登上《自然》,过了半年。
3月那篇论文发表的时候,美国媒体很兴奋,“CT界的ChatGPT”,这个标签被反复用。
Merlin确实是个突破,它能同时识别腹部CT上的30种疾病,首次实现了原生3D视觉语言模型在腹部CT上的应用,但论文里也写了一个硬伤:准确率还没到医生的平均水平。
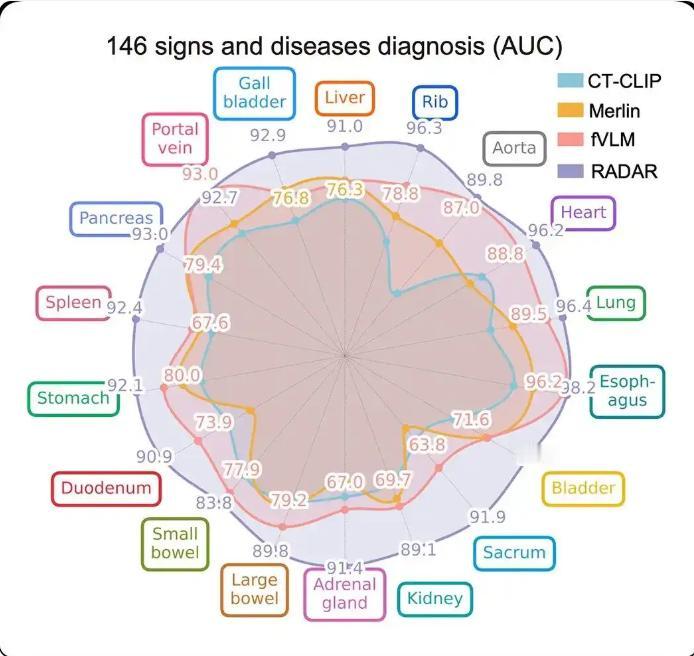
半年后,DAMO RADAR的数据出来了,146种病症,18个器官,AUC 0.913。
这个AUC指标衡量的是区分患者与正常人的能力,0.913放在腹部CT这种几十个器官、数百种潜在病变的复杂场景里,不是小进步。
更关键的是人机对比,26名来自多家医院的放射科医生参与试验,DAMO RADAR的平均准确率超过了其中23名。
在AI提示下,医生识别疾病的敏感性,也就是防漏诊的能力,提高了10%,阅片时间减少了30%以上,低年资医生在AI辅助下,能达到高年资医生的诊断水平。
这不是“AI比医生强”的简单叙事,腹部CT诊断是影像科最难的活之一,涉及数十个组织器官和数百种潜在异常。
一个放射科医生完成单例腹部CT解读,通常需要20分钟以上,而DAMO RADAR的设计目标,是成为医生的“导航”,把那些耗时费力的基础工作接过去。
技术路线上,达摩院做了一个和斯坦福不同的选择,Merlin的思路是“基础模型加任务适配”,先在海量数据上学通用表征,再根据具体任务微调。
DAMO RADAR走的是另一条路,达摩院高级算法专家张建鹏的解释是,CT数据信号稀疏,常规视觉-语言学习效果不好。
他们首次采用“器官级细粒度对齐”,把三维CT拆解成解剖单元,在组织器官层面让图像和报告文本精确匹配,不需要额外人工标注。
这个选择的结果是,DAMO RADAR天然具备泛化能力,面对训练数据之外的急诊场景,急腹症的AUC还能保持在0.904,不是背题背出来的,是真的学会了腹部影像的“语言”。
还有一个动作值得单独看,达摩院宣布DAMO RADAR正式开源,模型、代码都放出来,全球任何一家医院、任何一个研究团队都可以基于它做二次开发。
这个选择的分量在于:开源意味着技术路线的输出,谁的开源模型被用得最多,谁的技术标准就成了事实标准。
达摩院在医疗AI上的积累也不是突然冒出来的,三年内5篇《自然·医学》和10多篇其余顶刊论文,先后突破胰腺癌、胃癌、肠癌等消化系统肿瘤筛查,以及主动脉夹层预警。
从单病种突破到通用模型,路径是连贯的,DAMO RADAR不是从零开始,是站在一串已经被验证过的技术积累上,做了一次系统性的整合。
3月的时候,美国媒体叫Merlin“CT界的ChatGPT”,9月的时候,DAMO RADAR已经开源了。
这半年里没有人停下来庆祝,因为AI这个赛道上,庆祝的时间从来不属于跑得最快的那个人。