美国智库算了个“1%”,华为用75万颗芯片告诉它:你算错了
美国知名智库Epoch AI最近发了份报告,数据模型做得那叫一个精美。
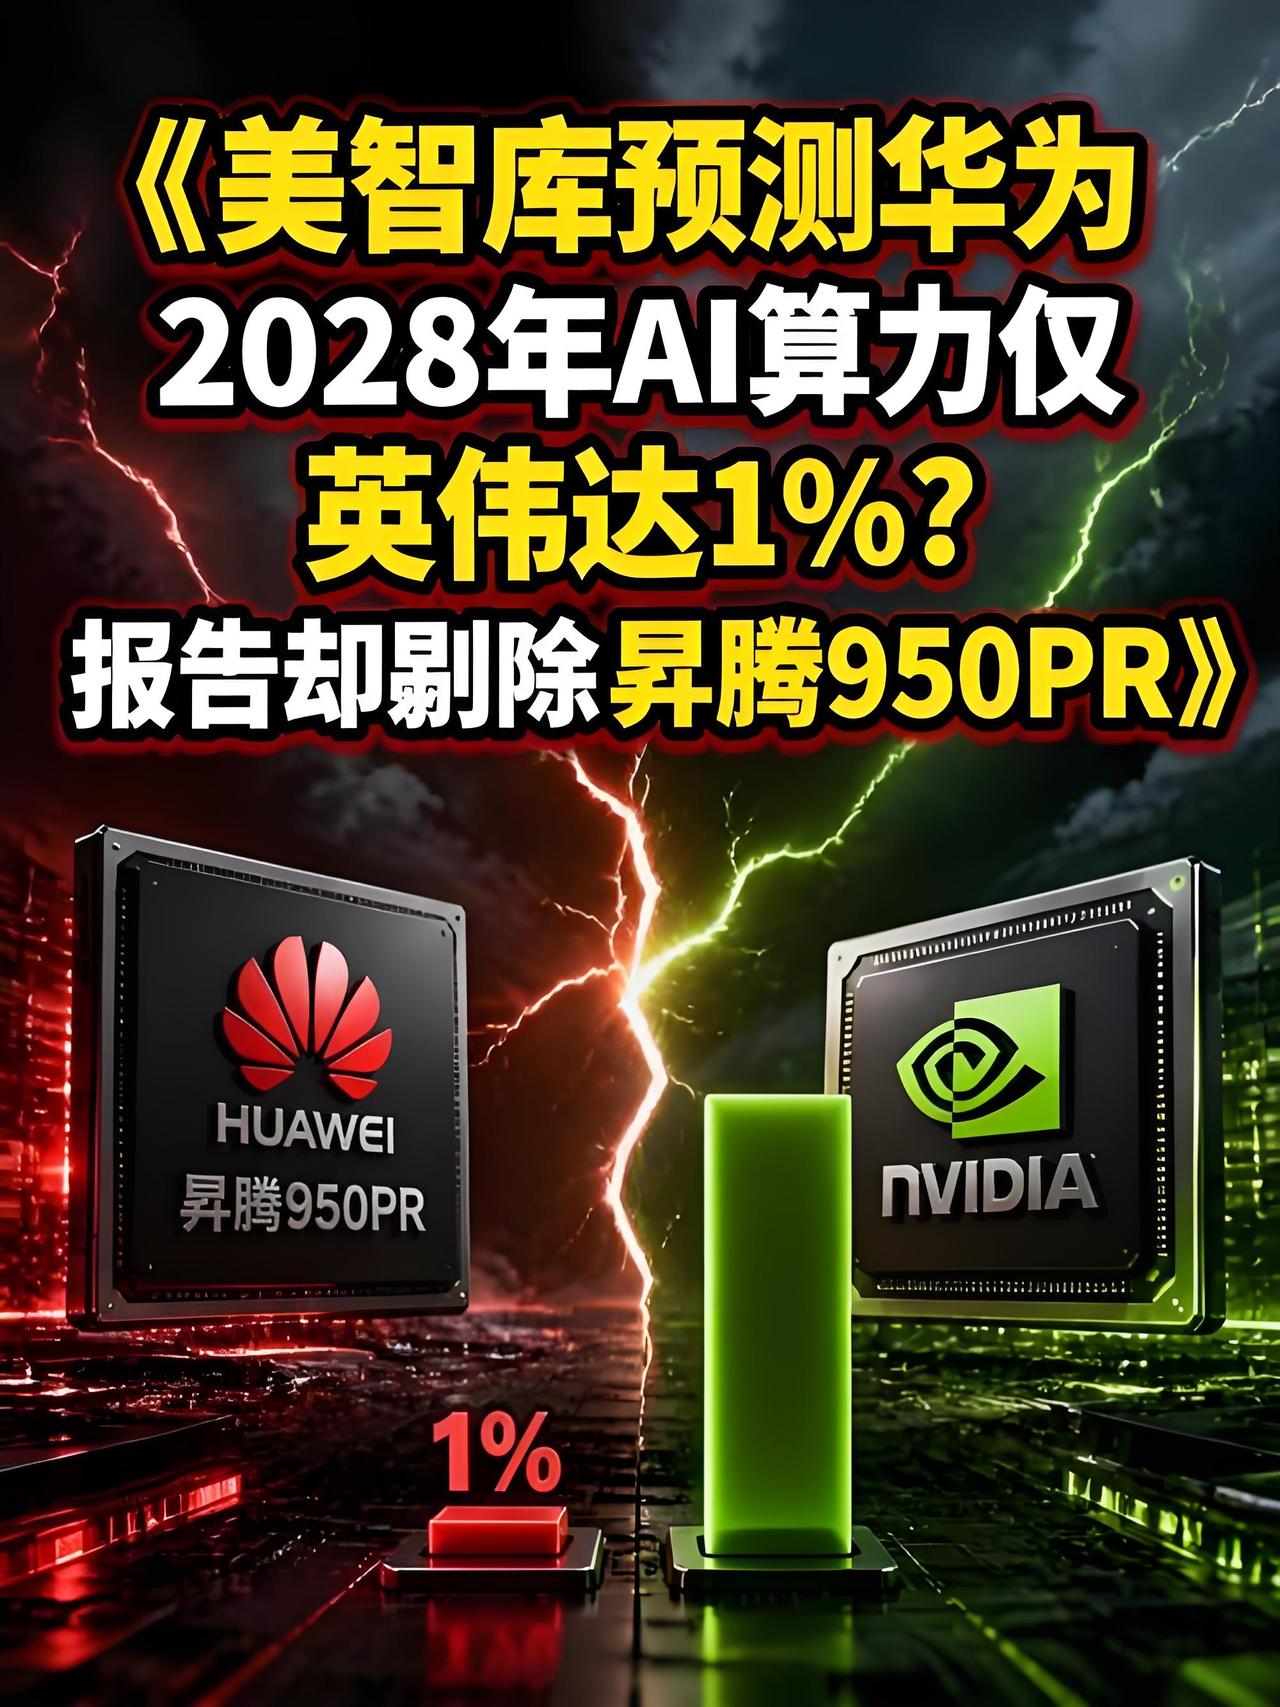
结论一句话:如果华为只用国产HBM,到2028年算力只有英伟达的1%。2026年0.5%,2027年0.8%,2028年1.0%。图表画得清清楚楚,结论下得斩钉截铁——“中国AI芯片正在超越美国的说法,与事实相去甚远。”
但这份报告底部藏着一行小字,才是整件事的精髓。
它写着:本预测未纳入华为预计于2026年交付的75万颗昇腾950PR芯片,原因是这些芯片采用的是LPDDR/HiBL内存,而非HBM。
换句话说,为了算出那个1%,他们把华为最核心的工程路径,从模型里删了。
不是算不出来,是算了就不成立。
华为压根没打算在HBM这条独木桥上死磕。950PR用的是自研HiBL 1.0内存方案,走LPDDR路线,供应链完全自主可控。逻辑很朴素:HBM不够,那就在推理的不同阶段做拆分。需要高带宽的解码环节交给HBM,Prefill阶段用成熟且充裕的LPDDR颗粒顶上。
华盛顿以为堵死HBM就一劳永逸。华为的回答接地气得很:你不给赛车专用油,我就用成熟颗粒组阵列。
Epoch AI的模型擅长Excel式的“单卡对单卡”线性推演。但面对“不用HBM也能跑AI”的工程方案,这套参数体系里根本没有对应的单元格可填。
如果单卡性能拼不过,那就拼系统。
CloudMatrix 384超节点,384颗昇腾NPU加192颗鲲鹏CPU,通过高速网络全对等互联,构建成一台超级AI服务器。SemiAnalysis拆解后的结论是:384颗昇腾910C协同运作,在系统性能指标上已能与英伟达GB200 NVL72掰手腕,内存容量和聚合带宽甚至更高。
代价当然有:功耗大约是GB200的4倍,需要更多芯片和更复杂的光互连。但关键在于,CloudMatrix 384能构建近49TB的池化内存空间,而英伟达同级别NVL72机柜只有13.8TB。
大模型处理超长文本推理时,拼的不是单卡峰值带宽,而是显存绝对容量。单卡性能有瓶颈,就用系统拓扑来补;显存吞吐受限,就用池化内存来填。这套打法在参数表上不好看,在集群规模上越跑越稳。
昇腾的迭代节奏是“一年一代、算力翻倍”。950PR明年一季度推出,950DT四季度上市,960在2027年四季度指标翻倍,970计划2028年亮相。
而Epoch AI的模型,只算到2028年华为用国产HBM能做出什么。它没算华为不走那条路。
更让华盛顿头疼的是,硬件之外的战线也在变。
DeepSeek的MLA机制把键和值压缩为低秩潜变量,在算法层面直接砍掉了超过50%的推理带宽需求。美国在丈量硬件管线的宽度,中国的工程师在改发动机的燃烧效率。
这不是“弯道超车”的浪漫叙事,是一条被逼出来的、但确实在跑通的现实路径。
必须说清楚:HBM这座高墙不是靠“变通”就能翻过去的。长鑫的HBM3良率目前约25%,SK海力士成熟期在90%以上,差距来自TSV工艺十年二十年的积累。单芯片性能上,昇腾与英伟达最新产品仍有代差。华为监事会主席郭平自己也承认,“在工艺受限情况下,通过架构创新缩小差距”。
但“缩小差距”和“只有1%”之间,隔着的不是技术鸿沟,是模型的选择性。
Epoch AI回答的问题是:“如果华为只能走HBM这条路,2028年能走多远?”
它被用来论证的结论是:“华为2028年算力只有英伟达的1%。”
把限定条件删掉,结论就成了另一个意思。
华盛顿的决策者们拿着这份报告,看到的是1%,松一口气。但中国的算力集群,正在用CloudMatrix的49TB池化内存、用75万颗不走HBM路线的950PR、用算法端砍掉的50%带宽需求,处理着亿万个Token。
真正的算力竞赛,从来不是谁的单卡参数更高。而是谁在真正解决问题。
华为 EpochAI 昇腾芯片 算力 中美科技